HyperLogLog: Menghitung Jutaan Item Unik dengan Beberapa Kilobyte
Pertanyaan yang terdengar sepele: “berapa banyak item unik di aliran data ini?” — berapa pengunjung unik, berapa alamat IP berbeda, berapa kata unik. Cara pasti adalah menyimpan semuanya di sebuah
set lalu menghitung ukurannya. Masalahnya, untuk satu juta item unik, set itu bisa memakan puluhan megabyte. HyperLogLog menjawab pertanyaan yang sama dengan sekitar 12 kilobyte — dan meleset hanya ~1%. Caranya nyaris seperti sulap.1. Masalahnya: menghitung yang unik itu mahal
Menghitung total item itu murah (cukup satu pencacah). Menghitung item unik mahal, karena kita harus mengingat apa saja yang sudah pernah dilihat agar tidak dihitung dua kali.
import tracemalloc
tracemalloc.start()
s = set()
for i in range(1_000_000):
    s.add(f"item-{i}")
print(round(tracemalloc.get_traced_memory()[0] / 1024 / 1024), "MB")
# ~81 MB
Satu juta item unik → ~81 MB. Kalau yang dihitung miliaran, pendekatan ini runtuh. Padahal sering kali kita tidak butuh angka yang tepat — cukup perkiraan yang bagus. Di situlah HyperLogLog bersinar.
2. Intuisi: menghitung nol di depan
Kuncinya adalah fungsi hash yang menyebar merata. Kalau sebuah hash menghasilkan deretan bit acak 0/1, maka:
- Peluang sebuah hash diawali 1 nol adalah 1/2.
- Diawali 2 nol → 1/4.
- Diawali k nol →
.
Balik logikanya: kalau di antara semua hash yang Anda lihat, yang paling banyak nol di depannya punya
k nol, itu pertanda Anda kemungkinan sudah melihat sekitar
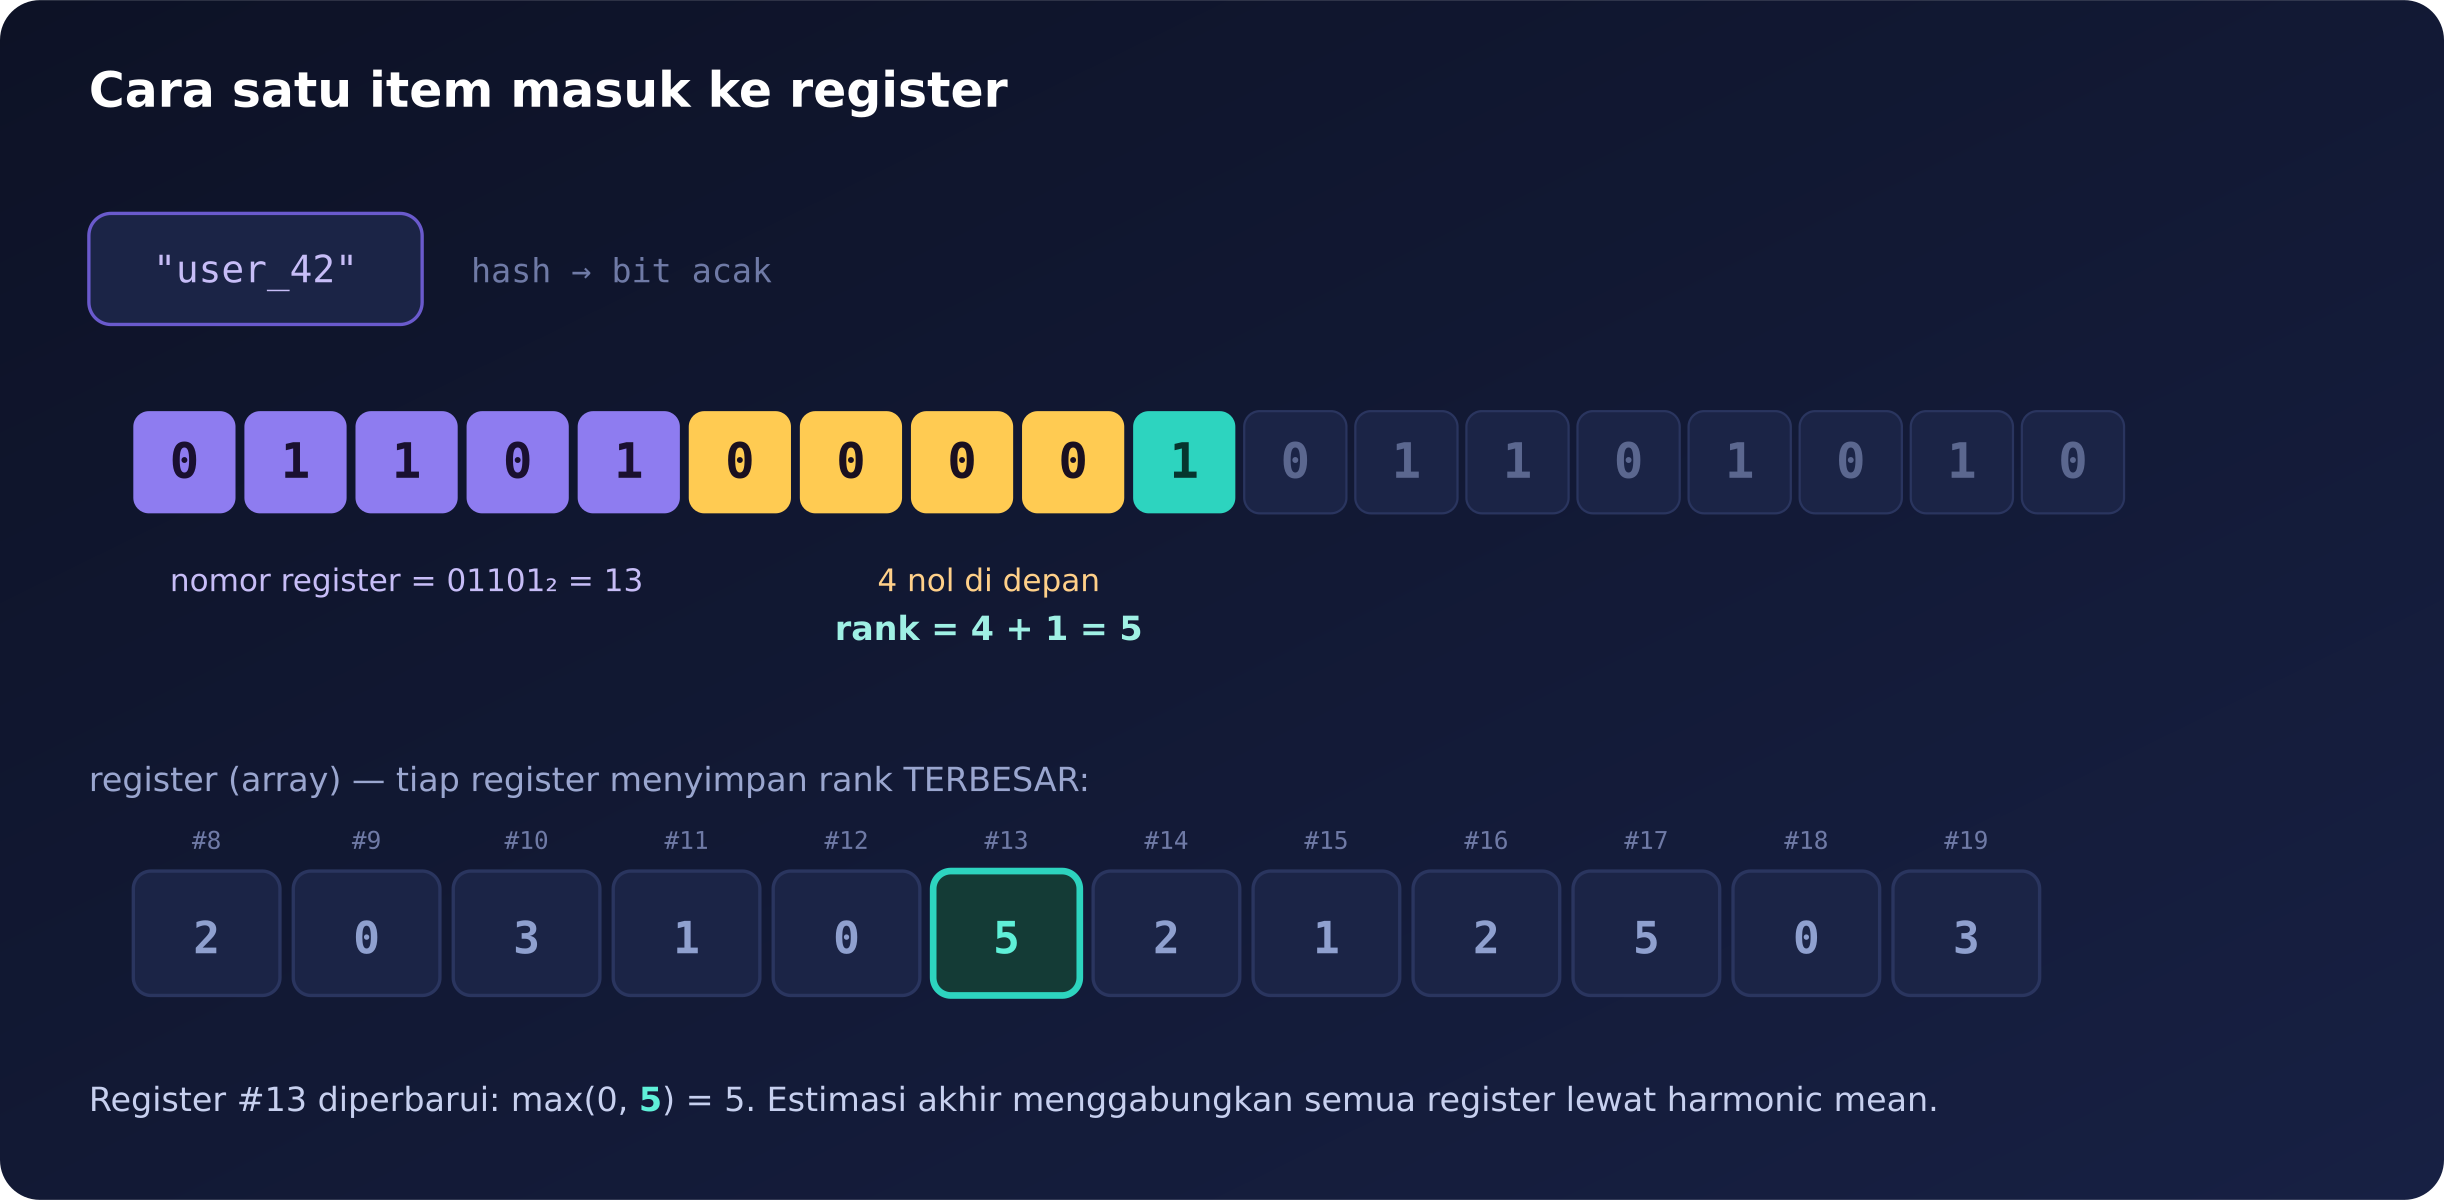
Setiap item di-hash. Sebagian bit menentukan register mana yang dipakai; sisanya dihitung berapa nol di depannya (rank). Tiap register hanya menyimpan rank terbesar yang pernah dilihat.
3. Dari satu tebakan berisik ke ribuan yang stabil
Satu penaksir “maksimum nol di depan” terlalu berisik — ia melonjak dalam kelipatan 2 dan mudah meleset jauh karena satu hash yang kebetulan ekstrem.
Solusi HyperLogLog: pecah jadi banyak register. Bit pertama hash dipakai memilih salah satu dari
m register; register itu menyimpan rank (jumlah nol di depan) terbesar dari bit sisanya. Dengan m penaksir independen, kita menggabungkannya memakai harmonic mean — yang jago meredam nilai pencilan:dengan
M[j] isi register ke-j, dan α_m sebuah konstanta koreksi bias. Untuk perkiraan yang sangat kecil, dipakai koreksi linear counting.Ketepatannya diatur oleh banyaknya register:
Dengan
m = 2^14 = 16.384 register (masing-masing cukup 6 bit → 12 KB), error-nya hanya sekitar 0,81%.4. Implementasi dari nol
import hashlib, math

def hash64(s):
    return int.from_bytes(hashlib.sha1(str(s).encode()).digest()[:8], "big")

class HyperLogLog:
    def __init__(self, p=14):
        self.p = p
        self.m = 1 << p                        # jumlah register = 2^p
        self.reg = bytearray(self.m)
        self.alpha = 0.7213 / (1 + 1.079 / self.m)

    def add(self, item):
        x = hash64(item)
        idx = x >> (64 - self.p)               # p bit pertama -> nomor register
        w = (x << self.p) & ((1 << 64) - 1)    # sisa bit, rata kiri
        rank = (64 - self.p) + 1 if w == 0 else (64 - w.bit_length() + 1)
        if rank > self.reg[idx]:
            self.reg[idx] = rank               # simpan rank terbesar

    def count(self):
        Z = sum(2.0 ** (-r) for r in self.reg)
        E = self.alpha * self.m ** 2 / Z
        V = self.reg.count(0)                  # register kosong
        if E <= 2.5 * self.m and V > 0:
            E = self.m * math.log(self.m / V)  # linear counting (range kecil)
        return E
Mari uji pada beberapa ukuran:
for n in [1_000, 10_000, 100_000, 1_000_000]:
    hll = HyperLogLog(p=14)
    for i in range(n):
        hll.add(f"item-{i}")
    est = hll.count()
    print(f"{n:>9,} -> {est:>10,.0f}  ({(est-n)/n*100:+.2f}%)")
Keluarannya:
    1,000 ->      1,004  (+0.42%)
   10,000 ->     10,024  (+0.24%)
  100,000 ->     98,583  (-1.42%)
1,000,000 ->    992,542  (-0.75%)
Satu juta item unik ditaksir 992.542 — meleset kurang dari 1% — memakai struktur 12 KB yang tetap, berapa pun banyaknya item.
5. Penghematan yang hampir tak masuk akal
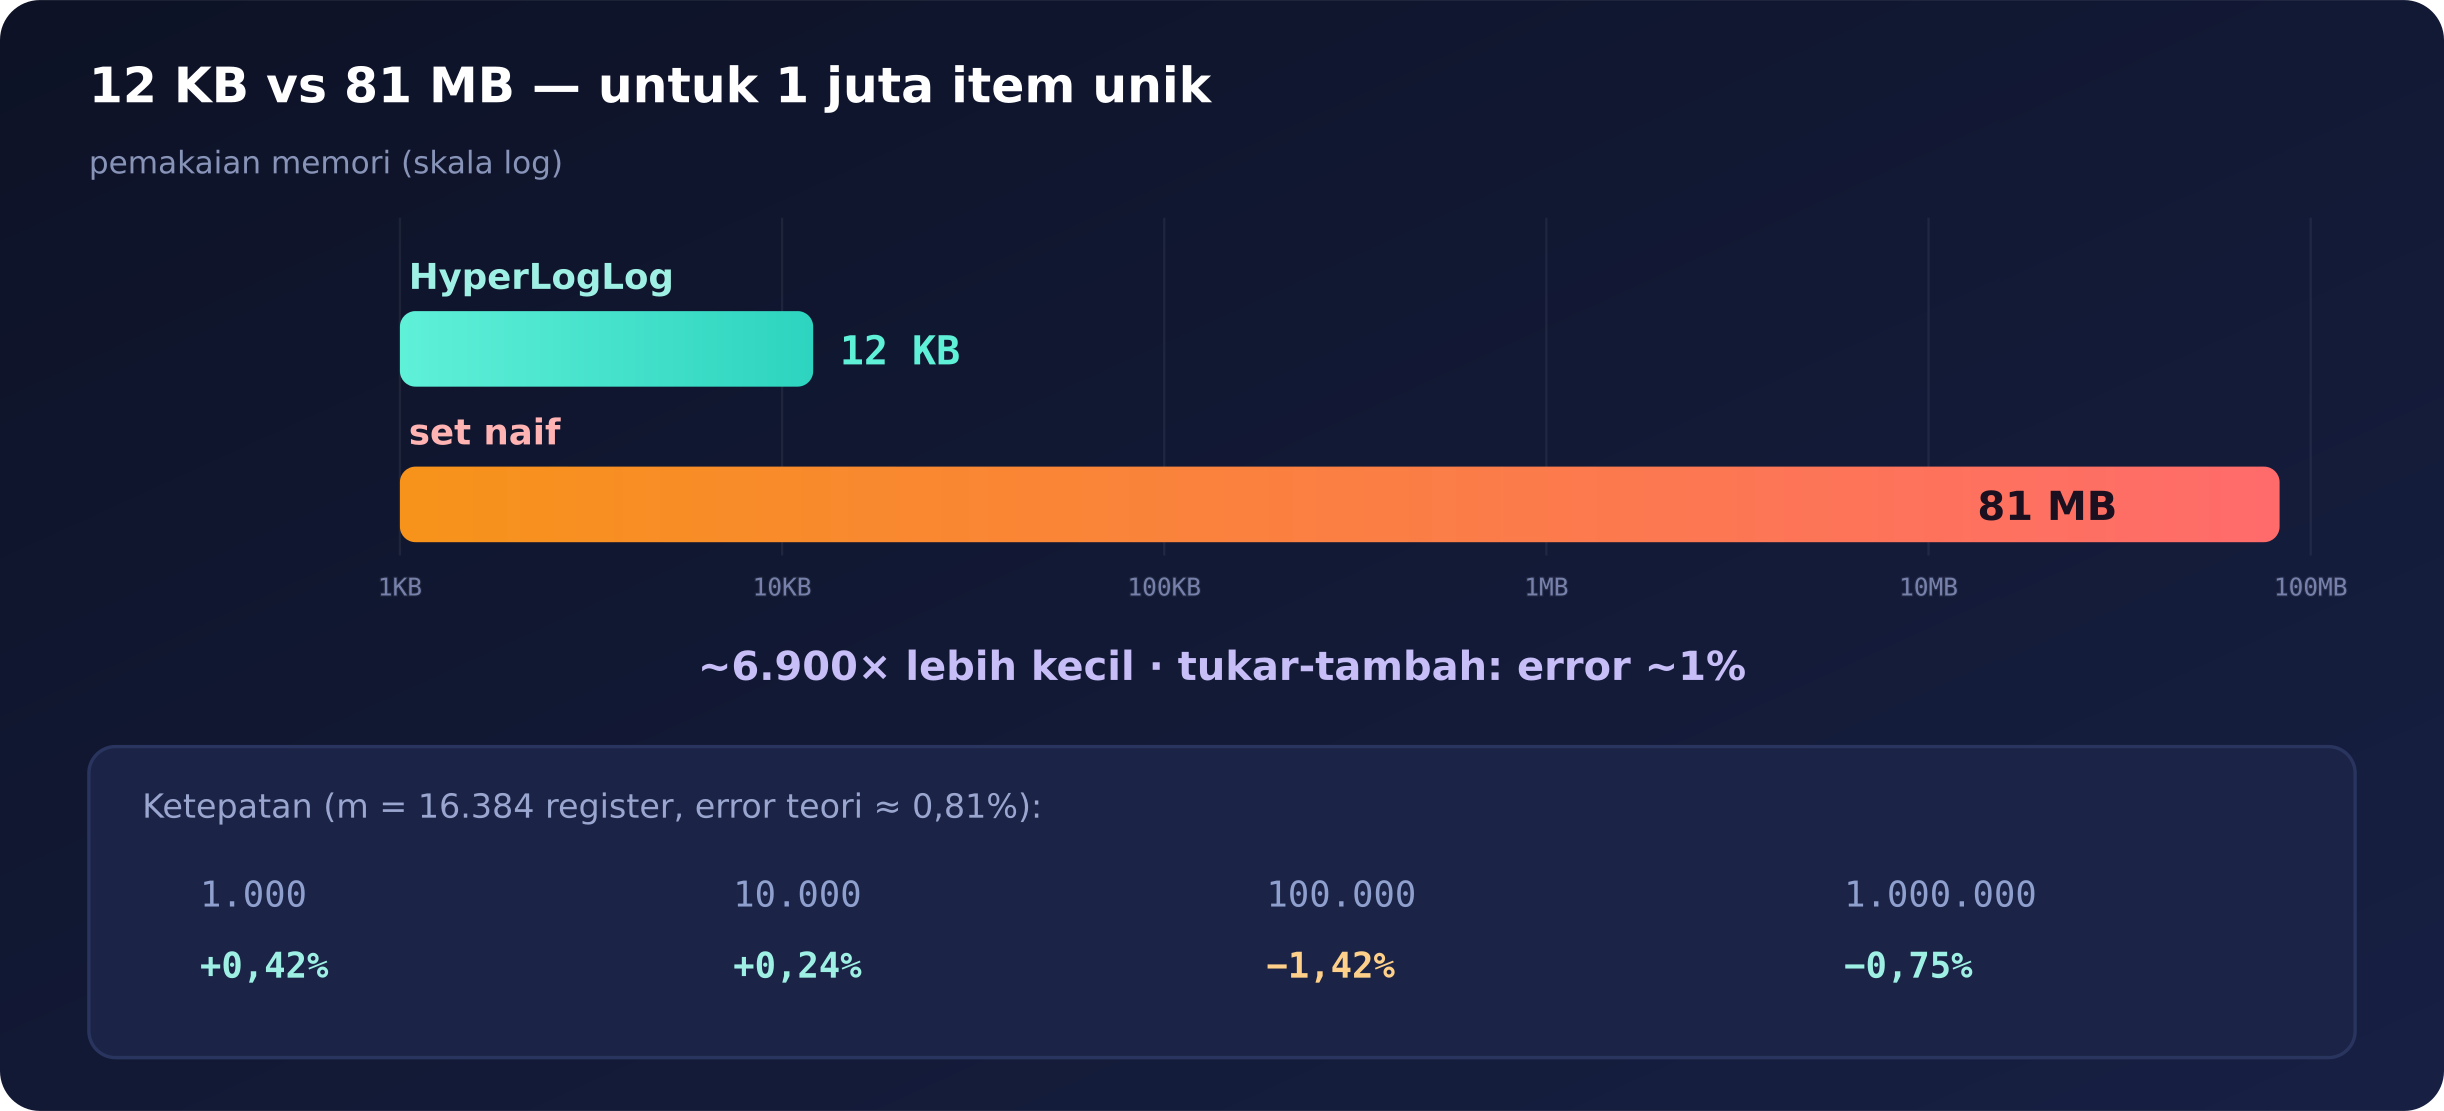
Untuk 1 juta item unik:
set naif ~81 MB, HyperLogLog ~12 KB — sekitar 6.900× lebih kecil, dengan tukar-tambah berupa error ~1%.set naif tadi butuh ~81 MB; HyperLogLog cukup ~12 KB. Itu sekitar 6.900× lebih kecil. Dan bagian terbaiknya: ukurannya tetap — mau menghitung seribu atau semiliar item unik, memorinya tidak bertambah. Yang berubah hanya ketepatan, dan itu pun bisa diatur lewat jumlah register.6. Dua sifat bonus
- Bisa digabung (mergeable). Dua HyperLogLog bisa disatukan dengan mengambil rank maksimum tiap register — tanpa melihat data aslinya. Jadi tiap server bisa menghitung lokal, lalu hasilnya digabung untuk mendapat jumlah unik global. Sempurna untuk sistem terdistribusi.
- Hanya-tambah, aman paralel. Menambah item hanya pernah menaikkan nilai register, tidak pernah menurunkan.
7. Di dunia nyata
Fungsi ini ada di hampir semua sistem data berskala besar:
- Redis — perintah
PFADD/PFCOUNT(nama ber-prefix “PF” untuk Philippe Flajolet, penemu algoritmanya). - Google BigQuery —
APPROX_COUNT_DISTINCT. - Presto/Trino, Apache Druid, Elasticsearch — agregasi kardinalitas unik.
Semuanya memilih jawaban “cukup tepat” yang murah daripada jawaban “persis” yang mahal.
Penutup
- Menghitung item unik secara pasti itu mahal karena harus mengingat semuanya.
- HyperLogLog menukar ketepatan ~1% demi memori yang nyaris tak bertambah, lewat trik menghitung nol di depan hash dan menggabungkan ribuan penaksir.
- Dengan 12 KB, ia menghitung jutaan—bahkan miliaran—item unik, dan dua HLL bisa digabung begitu saja.
Lain kali Anda melihat “sekian juta pengunjung unik” di sebuah dashboard, besar kemungkinan tak ada daftar sepanjang itu yang disimpan di baliknya — hanya beberapa kilobyte register dan sedikit matematika yang elegan.