Berapa Banyak Operasi yang Dihemat oleh Sebuah Index Database?
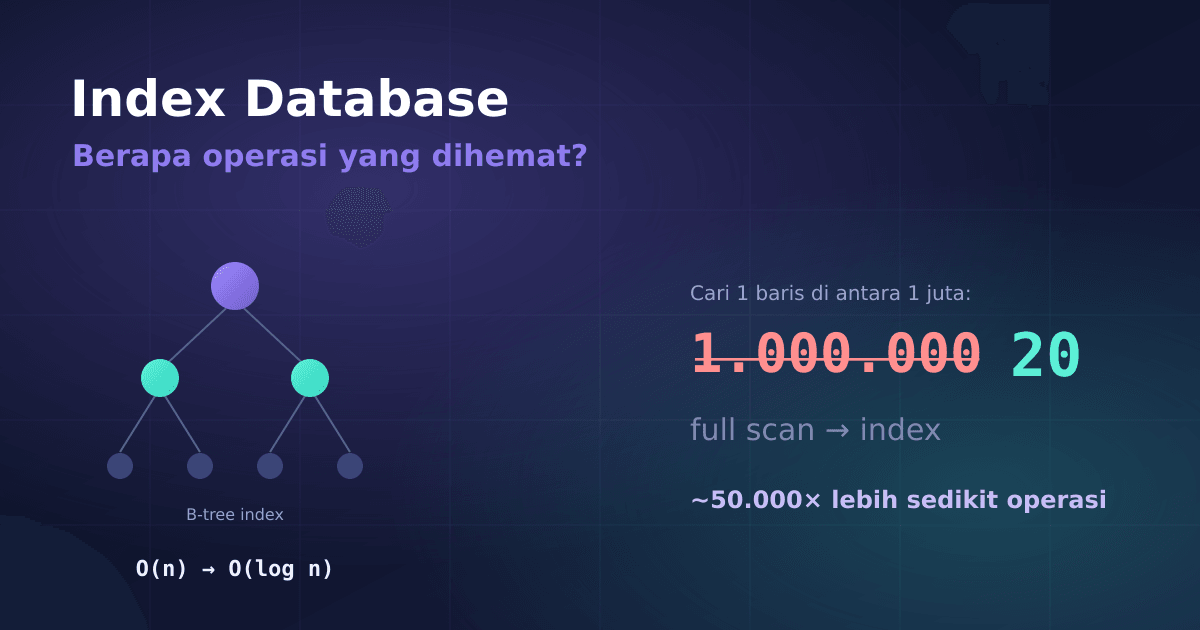
Pertanyaannya sederhana: kalau sebuah tabel punya satu juta baris, berapa banyak pekerjaan yang sebenarnya dihemat ketika kita menambahkan index pada kolom yang dicari? Jawabannya mengejutkan — dan itulah alasan kenapa satu baris
CREATE INDEX bisa mengubah query dari lambat menyakitkan menjadi instan.Analogi: buku tanpa dan dengan daftar indeks
Bayangkan sebuah buku 1.000 halaman tanpa daftar isi maupun indeks. Untuk menemukan satu kata, Anda harus membaca dari halaman pertama sampai ketemu — rata-rata memeriksa ratusan halaman. Itulah full table scan.
Sekarang tambahkan indeks di belakang buku. Anda langsung lompat ke huruf yang tepat, lalu ke entri yang tepat — hanya beberapa langkah. Itulah index database.
1. Tanpa index: O(n)
Tanpa index, database melakukan full table scan: memeriksa setiap baris satu per satu sampai menemukan yang cocok. Untuk tabel berisi
n baris, biayanya sebanding dengan n.Seribu baris berarti ~1.000 pemeriksaan. Satu juta baris berarti ~1.000.000 pemeriksaan.
2. Dengan index: O(log n)
Index umumnya berupa B-tree (lebih tepatnya B+ tree) — struktur terurut dan berjenjang. Mencari nilai di dalamnya mirip dengan binary search: setiap langkah membuang separuh kemungkinan yang tersisa.
Membuang separuh ruang pencarian di tiap langkah berarti jumlah langkah tumbuh sangat lambat — logaritmik. Satu juta baris hanya butuh sekitar 20 langkah, bukan sejuta.
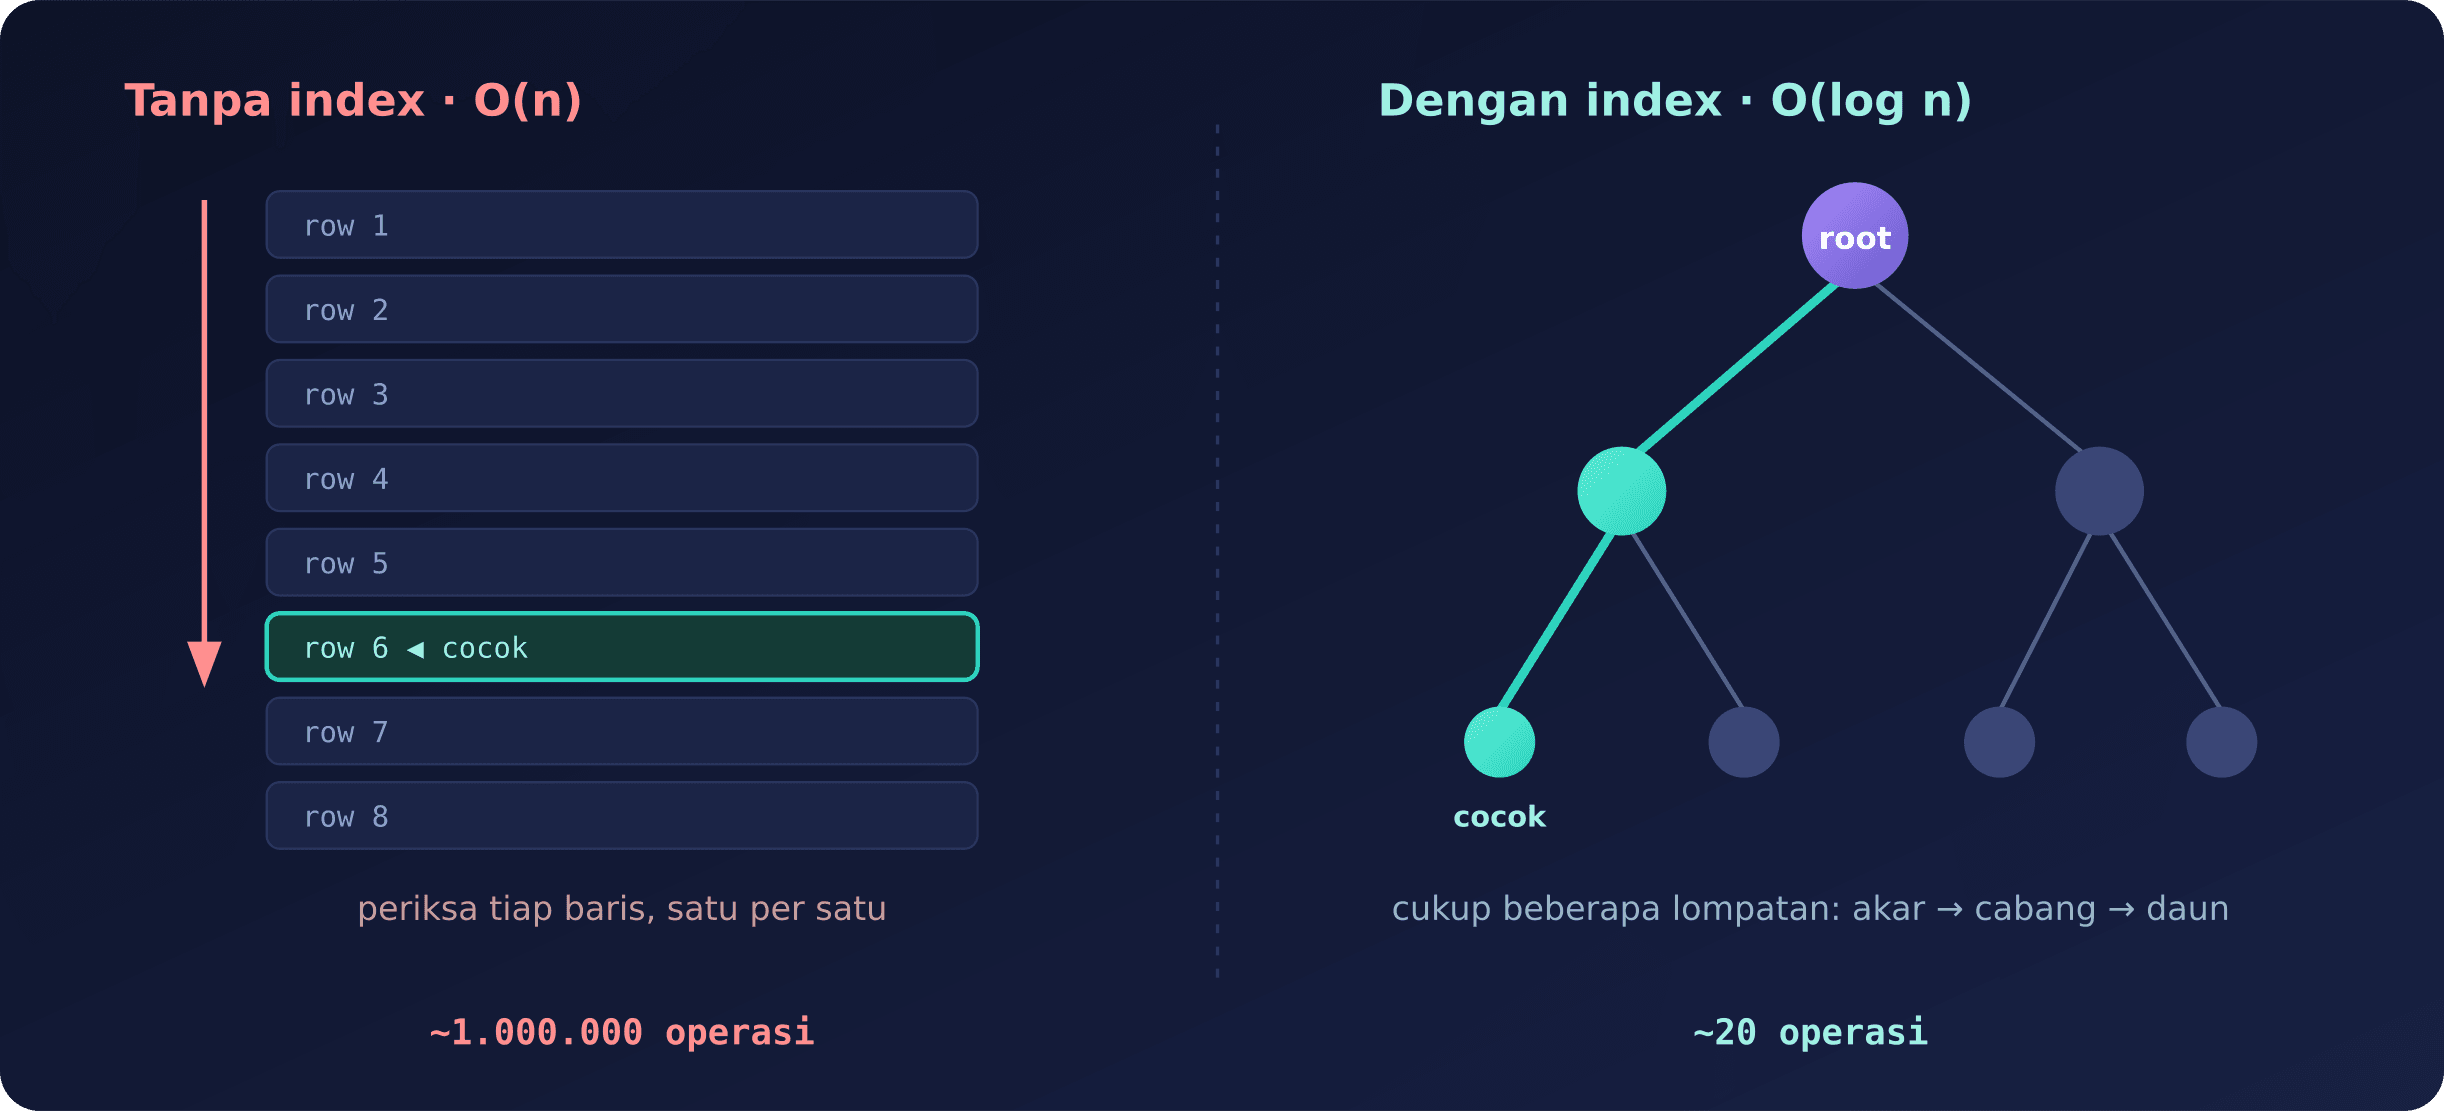
Full scan memeriksa seluruh baris (O(n)); index melompat dari akar ke daun lewat segelintir simpul (O(log n)).
3. Angkanya secara konkret
Inilah jawaban dari judul artikel ini — berapa operasi yang dihemat untuk berbagai ukuran tabel:
| Jumlah baris | Full scan | Index (~log₂ n) | Lebih cepat |
|---|---|---|---|
| 1.000 | 1.000 | 10 | ~100× |
| 10.000 | 10.000 | 14 | ~750× |
| 100.000 | 100.000 | 17 | ~6.000× |
| 1.000.000 | 1.000.000 | 20 | ~50.000× |
| 10.000.000 | 10.000.000 | 24 | ~430.000× |
| 100.000.000 | 100.000.000 | 27 | ~3.700.000× |
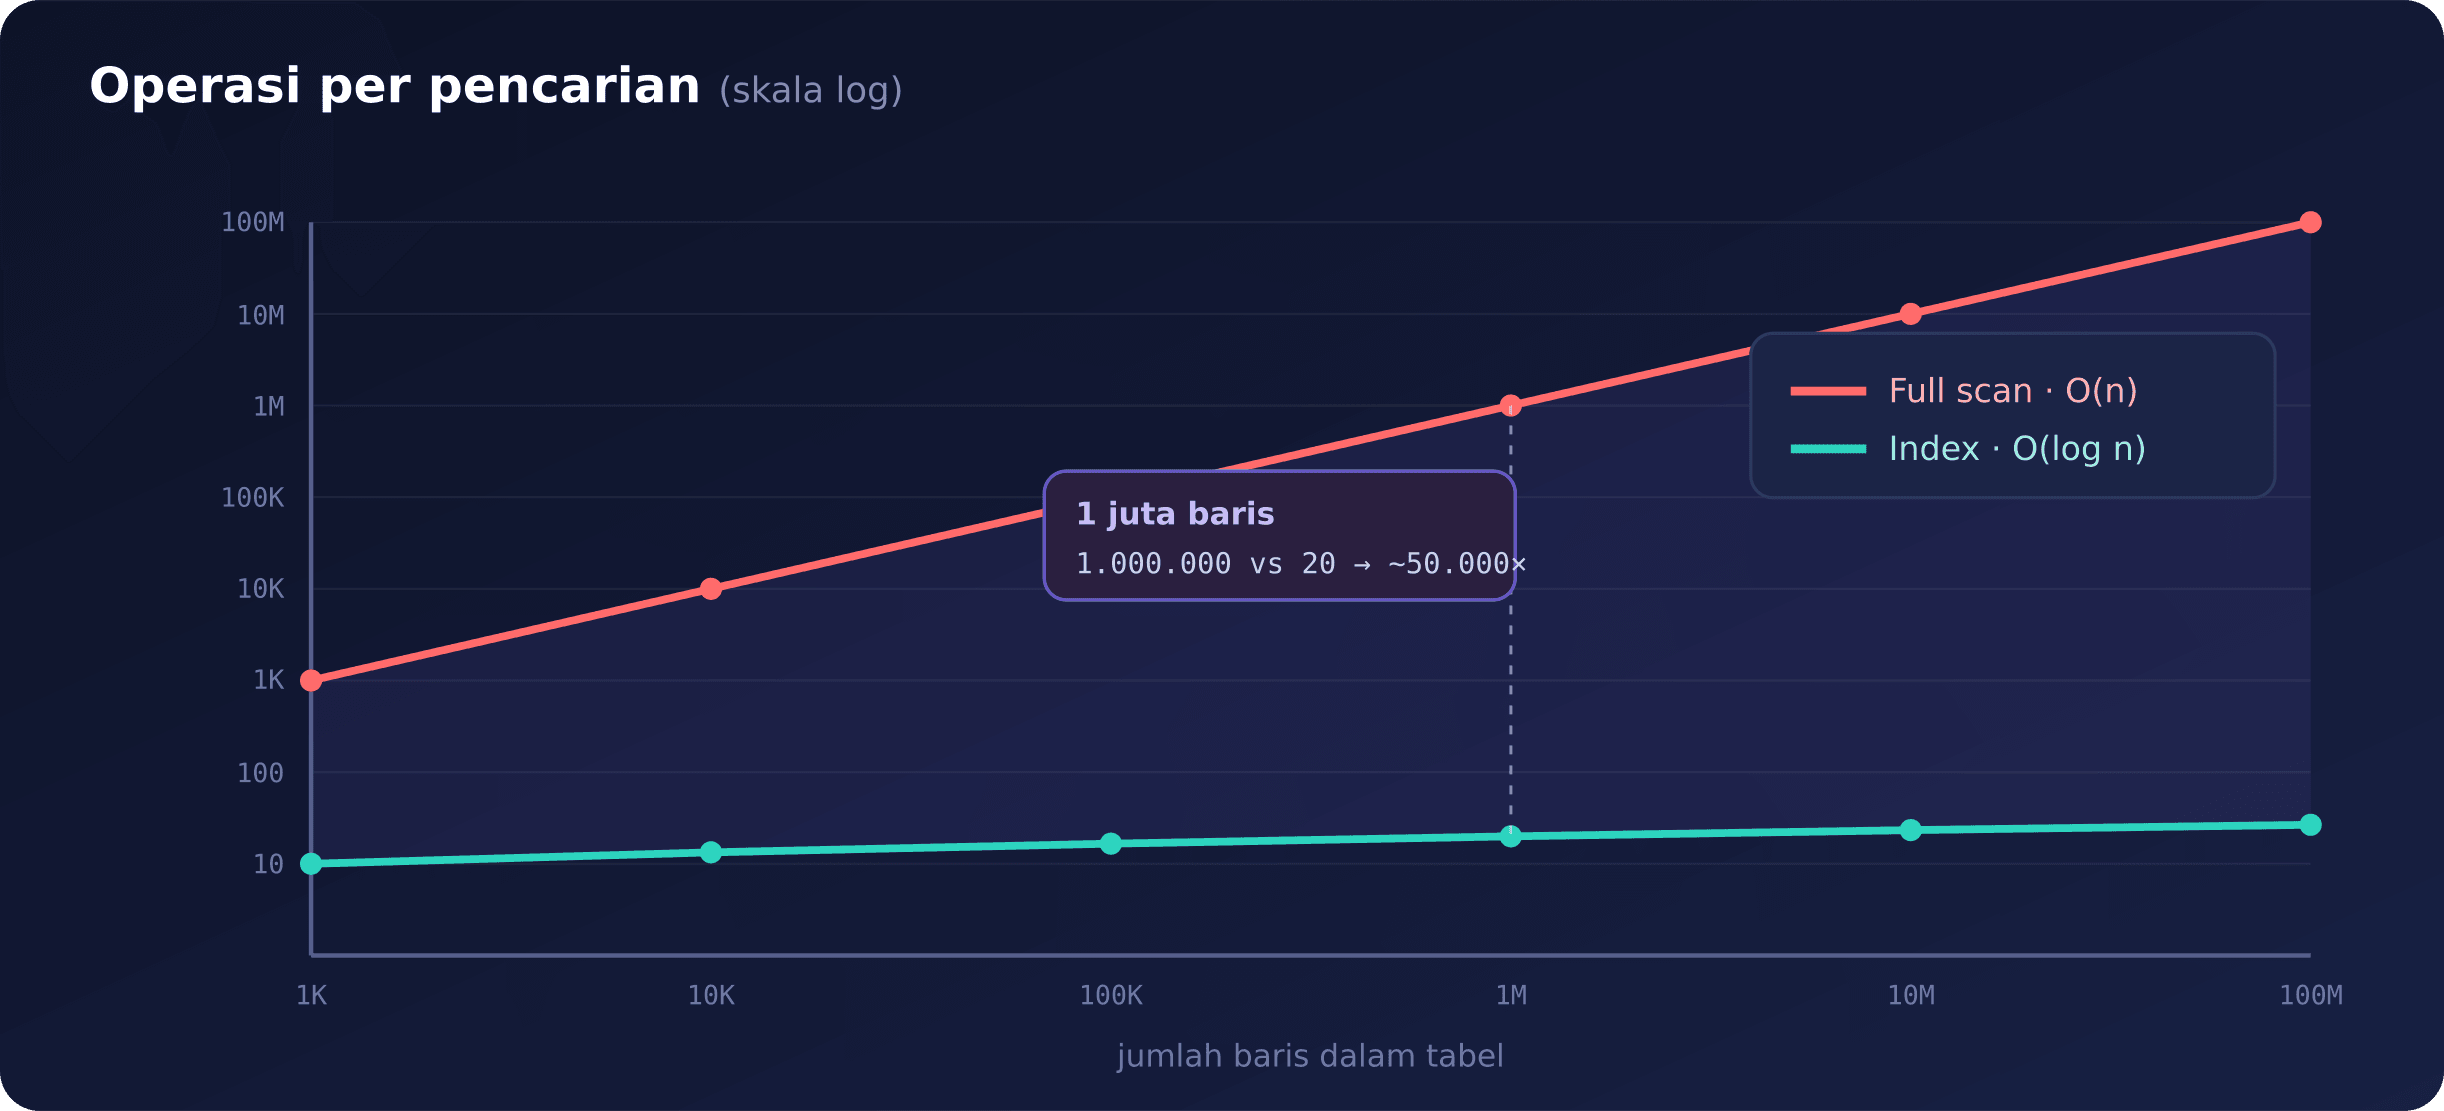
Saat tabel membesar, biaya full scan naik lurus mengikuti jumlah baris, sedangkan biaya index nyaris tak bergerak. Jurang di antaranya itulah yang dihemat.
Perhatikan polanya: tabel diperbesar 1.000×, biaya index hanya naik dari 20 ke 27 — tambah 7 langkah saja. Full scan, sebaliknya, ikut membesar 1.000×.
4. Buktikan dengan kode
import math

def ops_full_scan(n):
    return n                       # periksa tiap baris: O(n)

def ops_index(n):
    return math.ceil(math.log2(n)) # telusuri B-tree: O(log n)

for n in [1_000, 1_000_000, 100_000_000]:
    s, i = ops_full_scan(n), ops_index(n)
    print(f"{n:>13,} baris -> scan {s:>13,} vs index {i:>3}  ({s // i:,}x lebih sedikit)")
Keluarannya:
        1,000 baris -> scan         1,000 vs index  10  (100x lebih sedikit)
    1,000,000 baris -> scan     1,000,000 vs index  20  (50,000x lebih sedikit)
  100,000,000 baris -> scan   100,000,000 vs index  27  (3,703,703x lebih sedikit)
Dan ini binary search sungguhan di atas satu juta baris terurut — menghitung berapa langkah yang benar-benar dipakai:
def binary_search_ops(sorted_rows, target):
    lo, hi, ops = 0, len(sorted_rows) - 1, 0
    while lo <= hi:
        ops += 1
        mid = (lo + hi) // 2
        if sorted_rows[mid] == target:
            return ops
        elif sorted_rows[mid] < target:
            lo = mid + 1
        else:
            hi = mid - 1
    return -1

rows = list(range(1_000_000))        # 1 juta baris terurut (kolom ber-index)
print(binary_search_ops(rows, 999_999))
# 20
Dua puluh langkah untuk menemukan satu baris di antara sejuta. Full scan butuh hingga sejuta.
5. Di dunia nyata: yang mahal itu baca disk
Angka di atas menghitung perbandingan. Di database sungguhan, yang benar-benar mahal bukan perbandingan di memori, melainkan membaca halaman dari disk. Di sinilah B+ tree makin bersinar.
B+ tree punya fanout besar: satu simpul (halaman) bisa menampung ratusan kunci, sehingga pohonnya sangat pendek:
import math
for n in [1_000, 1_000_000, 100_000_000]:
    tinggi = math.ceil(math.log(n, 100))   # fanout ~100 kunci per halaman
    print(f"n={n:>12,} -> tinggi pohon {tinggi} level")
# n=       1,000 -> tinggi pohon 2 level
# n=   1,000,000 -> tinggi pohon 3 level
# n= 100,000,000 -> tinggi pohon 4 level
Artinya: menemukan satu baris di antara 100 juta baris hanya butuh membaca sekitar 4 halaman dari index — dibanding memindai seluruh tabel.
6. Harga sebuah index
Index bukan sihir gratis. Ada biayanya:
- Tulis jadi lebih lambat — setiap
INSERT,UPDATE,DELETEharus ikut memperbarui index. - Memakan ruang penyimpanan — index adalah struktur data tambahan di samping tabel.
- Tidak selalu membantu — pada kolom dengan selektivitas rendah (mis. kolom
jenis_kelaminyang cuma punya dua nilai), atau pada tabel kecil, full scan bisa sama cepat atau malah lebih murah, sehingga optimizer memilih mengabaikan index.
Penutup
Jadi, berapa operasi yang dihemat sebuah index?
- Dari O(n) menjadi O(log n).
- Untuk sejuta baris: dari ~1.000.000 menjadi ~20 langkah — sekitar 50.000× lebih sedikit.
- Makin besar tabel, makin besar penghematannya; biaya index nyaris tak bertambah.
Satu baris
CREATE INDEX di kolom yang tepat sering kali adalah optimasi dengan rasio hasil-terhadap-usaha tertinggi yang bisa Anda lakukan pada sebuah database.